業務目標
明確要解決的性能、擴容、穩定性、覆蓋、互連或運維問題,並確認上線優先級。
按品牌與產品線快速定位,減少查找成本。
進入品牌頁查看對應產品與專案資料;如已配置子分類,可在下方快速進入。
進入品牌頁查看對應產品與專案資料;如已配置子分類,可在下方快速進入。
進入品牌頁查看對應產品與專案資料;如已配置子分類,可在下方快速進入。
進入品牌頁查看對應產品與專案資料;如已配置子分類,可在下方快速進入。
進入品牌頁查看對應產品與專案資料;如已配置子分類,可在下方快速進入。
進入品牌頁查看對應產品與專案資料;如已配置子分類,可在下方快速進入。
構建實時AI應用的開發者往往受限於逐Token生成速度。DiffusionGemma將擴散模型的並行生成優勢引入文本生成領域,能一次性生成整個文本序列而非逐Token自回歸生成,顯著降低了生成延遲。NVIDIA為DiffusionGemma提供了完整部署方案,通過NIM微服務和TensorRT-LLM優化引擎,使開發者能在生產環境中高效運行該模型。部署...
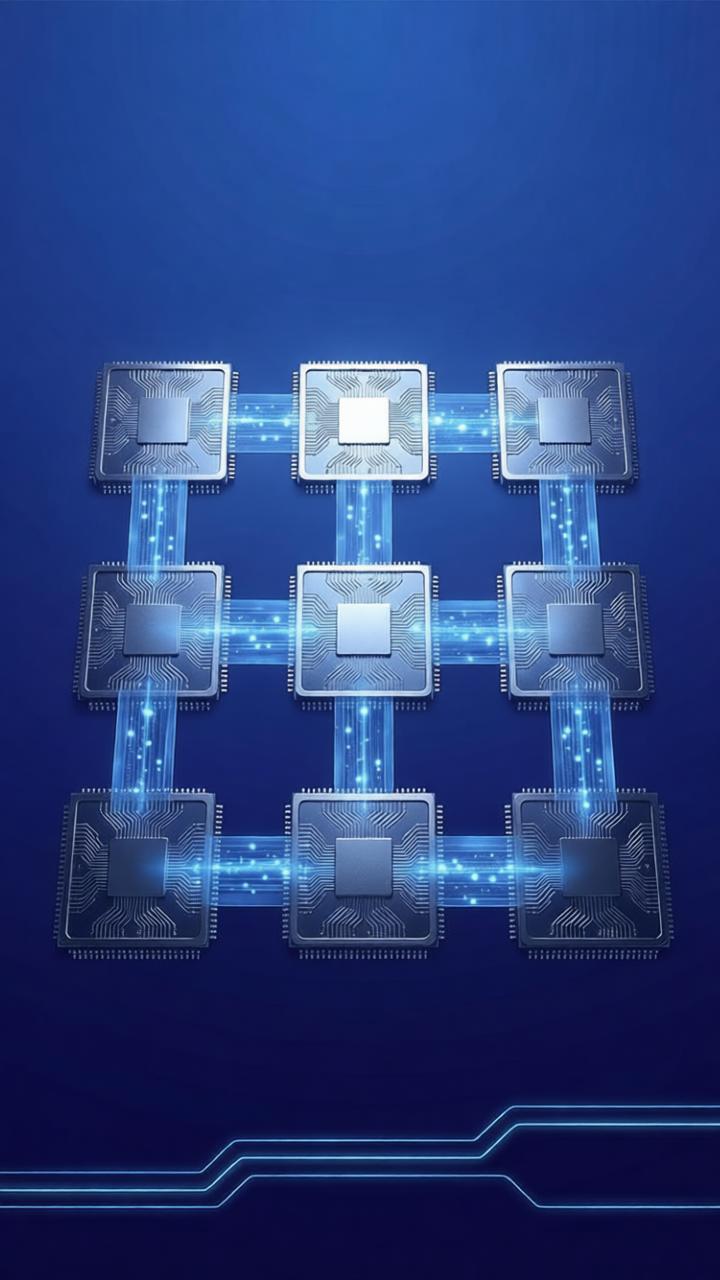
構建實時AI應用的開發者往往受限於逐Token生成速度。DiffusionGemma將擴散模型的並行生成優勢引入文本生成領域,能一次性生成整個文本序列而非逐Token自回歸生成,顯著降低了生成延遲。NVIDIA為DiffusionGemma提供了完整部署方案,通過NIM微服務和TensorRT-LLM優化引擎,使開發者能在生產環境中高效運行該模型。部署...
如果你正在評估對應場景,我們可以基於當前方案繼續細化產品組合、測試路徑與實施節奏。
瀏覽更多相關方案查看方案背景、關鍵能力與適配場景,幫助你更快判斷下一步應進入測試、諮詢還是部署階段。
構建實時AI應用的開發者往往受限於逐Token生成速度。DiffusionGemma將擴散模型的並行生成優勢引入文本生成領域,能一次性生成整個文本序列而非逐Token自回歸生成,顯著降低了生成延遲。NVIDIA為DiffusionGemma提供了完整部署方案,通過NIM微服務和TensorRT-LLM優化引擎,使開發者能在生產環境中高效運行該模型。
部署方案涵蓋模型量化、批處理優化和KV緩存管理等關鍵技術。通過FP8和INT4量化,模型在保持輸出品質的同時降低了顯存佔用。TensorRT-LLM的動態批處理和連續序列優化使併發推理吞吐量達到最優。在NVIDIA GPU上,DiffusionGemma端到端生成速度相比同等規模自回歸模型提高了3-5倍。對於在線客服、代碼自動補全和交互式寫作輔助等對延遲敏感的實時AI應用,DiffusionGemma結合NVIDIA加速基礎設施提供了高吞吐量、低延遲的文本生成方案。
在進入報價、測試或實施前,先把業務目標、現網條件和風險邊界整理清楚。
明確要解決的性能、擴容、穩定性、覆蓋、互連或運維問題,並確認上線優先級。
整理拓撲、服務器/交換機型號、接口速率、鏈路距離、供電散熱和現有管理平台。
確認是否需要 PoC、相容測試、吞吐測試、時延測試、無線覆蓋測試或故障切換測試。
確認交付窗口、責任分工、備件策略、培訓需求、驗收指標和後續擴容路徑。
企業網絡、AI 基礎設施與高性能連接解決方案合作夥伴
工作日 09:00 - 18:00,支援售前諮詢、專案對接與方案溝通。
立即諮詢通過微信或資料二維碼,快速獲取諮詢與企業資訊。
 WeChat
微信諮詢
 Profile
企業資料