業務目標
明確要解決的性能、擴容、穩定性、覆蓋、互連或運維問題,並確認上線優先級。
按品牌與產品線快速定位,減少查找成本。
進入品牌頁查看對應產品與專案資料;如已配置子分類,可在下方快速進入。
進入品牌頁查看對應產品與專案資料;如已配置子分類,可在下方快速進入。
進入品牌頁查看對應產品與專案資料;如已配置子分類,可在下方快速進入。
進入品牌頁查看對應產品與專案資料;如已配置子分類,可在下方快速進入。
進入品牌頁查看對應產品與專案資料;如已配置子分類,可在下方快速進入。
進入品牌頁查看對應產品與專案資料;如已配置子分類,可在下方快速進入。
開發自動駕駛策略需要彌合訓練與部署之間的關鍵鴻溝。視覺-語言-動作(VLA)模型能夠利用互聯網規模的圖文資料預訓練,再通過駕駛資料進行微調,展現出在駕駛場景中理解和行動的能力。然而,傳統的開環訓練方式——模型在靜態資料集上學習預測正確的駕駛動作——無法讓模型體驗自身決策的後果,導致在真實道路上面臨分布偏移
開發自動駕駛策略需要彌合訓練與部署之間的關鍵鴻溝。視覺-語言-動作(VLA)模型能夠利用互聯網規模的圖文資料預訓練,再通過駕駛資料進行微調,展現出在駕駛場景中理解和行動的能力。然而,傳統的開環訓練方式——模型在靜態資料集上學習預測正確的駕駛動作——無法讓模型體驗自身決策的後果,導致在真實道路上面臨分布偏移
如果你正在評估對應場景,我們可以基於當前方案繼續細化產品組合、測試路徑與實施節奏。
瀏覽更多相關方案查看方案背景、關鍵能力與適配場景,幫助你更快判斷下一步應進入測試、諮詢還是部署階段。
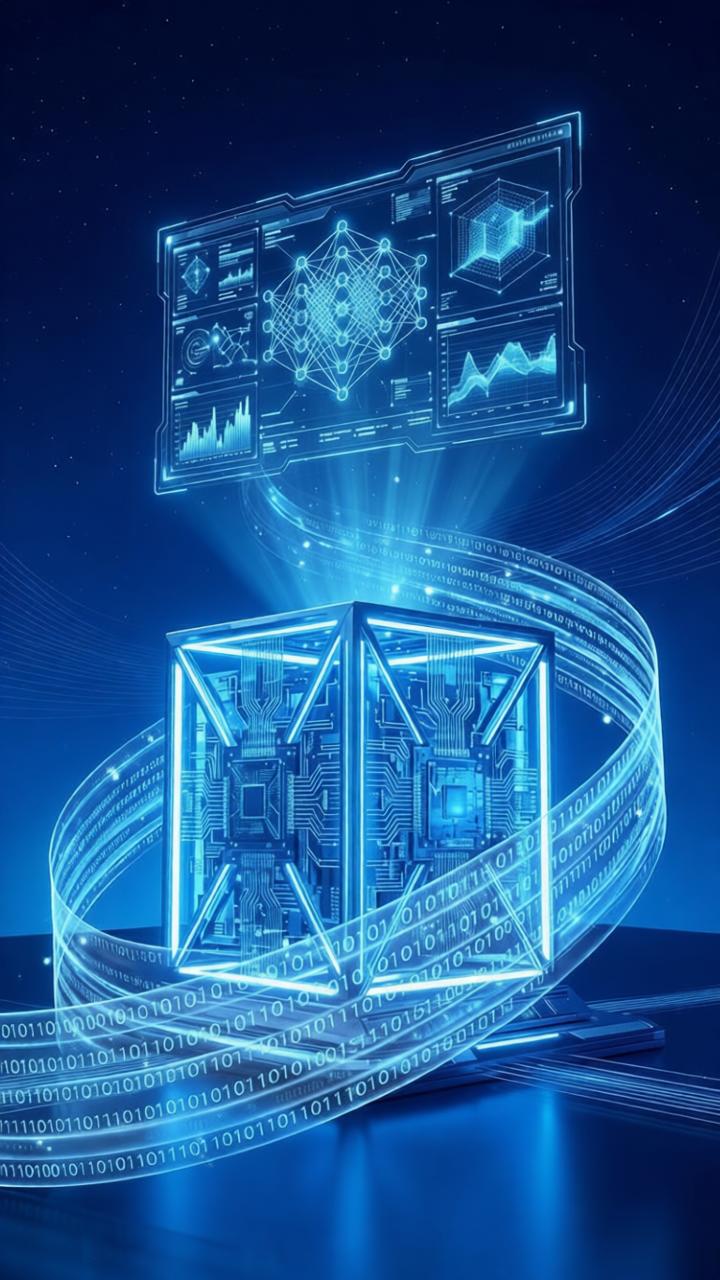
開發自動駕駛策略需要彌合訓練與部署之間的關鍵鴻溝。視覺-語言-動作(VLA)模型能夠利用互聯網規模的圖文資料預訓練,再通過駕駛資料進行微調,展現出在駕駛場景中理解和行動的能力。然而,傳統的開環訓練方式——模型在靜態資料集上學習預測正確的駕駛動作——無法讓模型體驗自身決策的後果,導致在真實道路上面臨分布偏移時表現不穩定。NVIDIA Alpamayo正是為解決這一挑戰而設計,它是一個閉環訓練框架,讓自動駕駛策略模型在逼真的仿真環境中不斷試錯和學習。
Alpamayo的工作流程包括三個階段:首先在真實駕駛資料上進行開環預訓練,使模型具備基礎的感知和駕駛能力;然後在NVIDIA Omniverse構建的高保真仿真環境中進行閉環策略學習,模型在仿真器中自主駕駛並接收獎勵信號,通過強化學習優化駕駛策略;最後將訓練好的策略遷移到真實車輛上進行驗證和微調。通過在仿真環境中經歷數百萬英里的駕駛體驗,包括各種邊緣場景和危險情況,Alpamayo訓練出的自動駕駛策略在安全性、流暢性和泛化能力上顯著優於僅通過開環訓練得到的模型。這一方法正在成為L3/L4級自動駕駛策略開發的標準範式,有效解決了仿真到現實(sim-to-real)的遷移鴻溝。
在進入報價、測試或實施前,先把業務目標、現網條件和風險邊界整理清楚。
明確要解決的性能、擴容、穩定性、覆蓋、互連或運維問題,並確認上線優先級。
整理拓撲、服務器/交換機型號、接口速率、鏈路距離、供電散熱和現有管理平台。
確認是否需要 PoC、相容測試、吞吐測試、時延測試、無線覆蓋測試或故障切換測試。
確認交付窗口、責任分工、備件策略、培訓需求、驗收指標和後續擴容路徑。
企業網絡、AI 基礎設施與高性能連接解決方案合作夥伴
工作日 09:00 - 18:00,支援售前諮詢、專案對接與方案溝通。
立即諮詢通過微信或資料二維碼,快速獲取諮詢與企業資訊。
 WeChat
微信諮詢
 Profile
企業資料